전 글에선, 서버와 스위치의 라우팅부터 Clos, VXLAN/EVPN까지 정리했다. 이번에는 그 물리망 위에 k8s를 올렸을 때 패킷이 어떻게 움직이는지 보려고 한다.
서버에 IP를 할당하고 gateway를 연결하는 것까지는 같다. 달라지는 건 서버 안에 Pod별 네트워크가 추가된다는 점이다. 노드끼리 ping이 된다고 Pod끼리도 통신되는 건 아니고, Pod에 직접 접근되는 것과 Service로 접근되는 것도 따로 확인해야 한다.
여기서는 Linux 노드와 IPv4를 기준으로 본다. 먼저 Pod가 노드에 붙는 구조를 보고, 같은 Pod 통신을 native routing과 VXLAN으로 각각 따라가 보자. 마지막에는 BGP로 Pod 대역을 광고하는 것과 Service VIP를 광고하는 것의 차이까지 연결한다.
Pod의 네트워크는 어디에 있나
일반적인 Pod는 노드와 분리된 network namespace를 가진다. 인터페이스, IP, routing table 같은 네트워크 상태를 따로 두는 Linux 기능이다. 이 namespace는 Kubernetes에서 리소스를 묶는 Namespace와는 다른 개념이다.
같은 Pod에 속한 컨테이너들은 이 network namespace를 공유한다. 그래서 컨테이너마다 IP를 하나씩 받는 게 아니라 Pod IP를 함께 쓰고, 서로 localhost로 통신할 수 있다. 반대로 같은 Pod에서 두 프로세스가 같은 주소와 포트에 동시에 listen하려 하면 충돌한다. hostNetwork: true인 Pod는 노드의 네트워크를 공유하므로 여기서 보는 일반적인 Pod 구성과는 다르다. (Kubernetes Pod networking)
Pod와 노드는 흔히 veth pair로 연결한다. 한쪽은 Pod 안의 eth0, 반대쪽은 노드 안의 인터페이스가 된다. 한쪽에 넣은 프레임이 반대쪽으로 나오는 가상 링크로 보면 된다.
Pod의 network namespace          노드의 network namespace

  app / sidecar
       │
      eth0  ←──── veth pair ────→  lxc... / cali... / veth...
                                      │
                                라우팅·bridge·eBPF 처리
                                      │
                                  물리 NIC
노드 쪽 인터페이스 이름이나 패킷을 처리하는 방식은 네트워크 구현에 따라 다르다. 모든 k8s 노드에 docker0 같은 bridge가 있는 건 아니다. bridge로 연결하는 구성도 있고, Pod별 경로와 eBPF를 쓰는 구성도 있다. veth와 bridge 자체의 동작은 Docker로 살펴본 Linux 네트워크 가상화에서 따로 실험했다.
CNI, IPAM, Service 처리를 구분하기
CNI(Container Network Interface)는 컨테이너를 네트워크에 연결할 때 런타임과 플러그인이 사용하는 인터페이스 규격이다. 실무에선 Calico나 Cilium 같은 네트워크 구현 전체를 두고 “어떤 CNI를 쓰나”라고 부르는 경우가 많다.
Pod의 네트워크를 준비할 때는 인터페이스를 연결하고, 주소와 필요한 경로를 설정해야 한다. 주소를 어느 대역에서 할당하고 회수할지 관리하는 부분이 **IPAM(IP Address Management)**이다. CNI 플러그인이 별도 IPAM 플러그인에 이 작업을 맡길 수도 있다. (CNI 규격)
이때 역할을 대략 나누면 아래와 같다. 하나의 프로젝트가 여러 역할을 같이 구현할 수 있다.
| 역할 | 하는 일 |
|---|---|
| CNI 플러그인과 노드 에이전트 | Pod 연결, 경로·터널·네트워크 정책 등 구성 |
| IPAM | Pod IP와 할당 대역 관리 |
| kube-proxy 또는 이를 대체하는 구현 | Service 주소로 들어온 통신을 backend로 전달 |
| BGP speaker | Pod 대역이나 Service VIP를 라우터에 광고 |
예를 들어 Cilium을 쓴다고 무조건 VXLAN만 쓰는 것도 아니고, BGP를 켰다고 Service 처리가 전부 해결되는 것도 아니다. 아래에서는 실제로 패킷을 전달하는 방식부터 보자.
예시 구성: 노드 두 대와 Pod 두 개
아래는 Cilium 공식 문서의 native routing 그림이다. 이 그림의 IP를 계속 사용하되, 왼쪽 노드를 Node A, 오른쪽을 Node B라고 부르겠다.
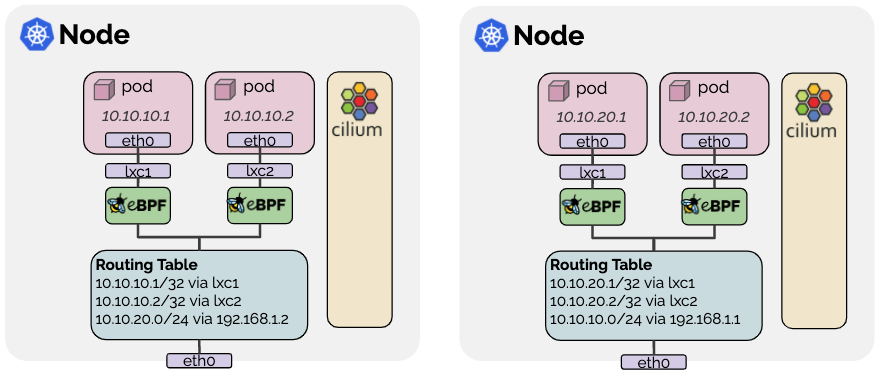
| 구분 | Node A (왼쪽) | Node B (오른쪽) |
|---|---|---|
| Node IP | 192.168.1.1 | 192.168.1.2 |
| Pod 대역 | 10.10.10.0/24 | 10.10.20.0/24 |
| 예시에서 사용할 Pod | Pod A: 10.10.10.1 | Pod B: 10.10.20.1 |
Node IP는 그림의 next hop에서 읽을 수 있다. lxc1, lxc2는 각 Pod에 연결된 노드 쪽 인터페이스다. 그림에서는 노드별로 /24 대역을 나눴지만, 실제 Pod 대역 할당 단위는 IPAM 방식에 따라 달라질 수 있다.
이제 Pod A가 Pod B의 IP로 직접 보낸다고 하자. 아래 경로 예시는 NetworkPolicy 등에서 통신을 허용하고, 돌아오는 경로도 구성돼 있다는 전제다.
같은 노드의 Pod끼리 통신하면
그림의 10.10.10.1 → 10.10.10.2는 Node A 안에서 처리할 수 있다. Node A가 목적지 Pod에 연결된 인터페이스로 전달하면 되므로, 이 구성에서는 패킷이 물리 NIC를 나가거나 spine을 거칠 필요가 없다.
같은 노드에 있는 Pod도 서로 다른 network namespace를 쓰므로 localhost로 접근하는 건 아니다. 상대 Pod IP를 사용한다. 같은 Pod 안의 컨테이너 간 통신과 혼동하기 쉬운 부분이다.
다른 노드로 보내기: native routing
다시 10.10.10.1 → 10.10.20.1로 가보자. 그림처럼 Node A와 B가 같은 L2 망에 있고, 서로의 Pod 대역으로 가는 경로가 설치돼 있다면 터널 없이 보낼 수 있다.
Node A에서 보는 경로 (그림을 단순화한 예시)
10.10.10.1/32  dev lxc1
10.10.10.2/32  dev lxc2
10.10.20.0/24 via 192.168.1.2- Pod A의 패킷이 노드 쪽으로 전달된다. 목적지 IP는
10.10.20.1이다. - Node A는
10.10.20.0/24 via 192.168.1.2경로를 선택하고, Node B를 next hop으로 보낸다. - Node B는 자신의
10.10.20.1/32경로를 보고 Pod B에 연결된lxc1로 전달한다.
여기서 next hop을 고르는 것과 목적지 IP를 바꾸는 것은 다르다. Node A는 Node B의 MAC을 목적지로 Ethernet 프레임을 만들지만, 그 안의 IP 패킷은 계속 10.10.10.1 → 10.10.20.1이다. 응답도 Node B가 Node A의 Pod 대역으로 가는 경로를 알아야 돌아올 수 있다.
이 그림에서는 스위치가 두 노드 사이의 프레임을 L2로 전달하면 된다. 노드들이 서로 다른 L3 구간에 있으면 중간 라우터에도 Pod 대역으로 가는 경로가 필요하다. 터널을 사용하지 않는 대신, 통신 경로에 있는 장비들이 Pod IP를 라우팅할 수 있어야 한다. (Cilium Native-Routing)
그림 자체에 BGP가 등장하는 건 아니다. 필요한 경로를 넣는 방법에는 직접 설정, 같은 L2 노드 간 경로 자동 설정, BGP를 통한 경로 교환 등이 있고, native routing은 그 경로로 패킷을 감싸지 않고 전달하는 방식을 가리킨다.
같은 통신을 VXLAN overlay로 보내면
이번에는 같은 IP 배치를 VXLAN overlay로 구성했다고 하자. Node A는 목적지 Pod가 Node B에 있다는 정보를 바탕으로 패킷을 감싸고, 바깥 목적지 IP에 Node B의 주소를 넣는다.
Native routing
  IP: 10.10.10.1 → 10.10.20.1
  next hop: 192.168.1.2

VXLAN overlay
  Outer IP: 192.168.1.1 → 192.168.1.2
    UDP / VXLAN
      원본 프레임
        Inner IP: 10.10.10.1 → 10.10.20.1
물리망은 Node IP 사이의 통신만 처리하고, Node B가 바깥 헤더를 벗긴 뒤 Pod B로 전달한다. 원격 Pod 대역과 노드를 연결하는 정보는 CNI 구현의 에이전트 등이 관리한다. Kubernetes API에서 얻은 노드·Pod 대역 정보를 터널 구성에 반영하는 식이다.
1편의 VXLAN 그림에서는 leaf가 VTEP을 맡았지만, 여기서는 k8s 노드가 터널의 양 끝을 맡는다. 따라서 물리망에 Pod 경로를 직접 넣지 않아도 된다. 노드가 여러 랙에 걸쳐 있어도 Node IP끼리 도달할 수 있고 터널 트래픽이 허용되면 같은 방식으로 구성할 수 있다. (Cilium Encapsulation)
터널을 쓰면 MTU도 달라진다
바깥 IP가 IPv4인 일반적인 VXLAN에서는 encapsulation으로 50B가 늘어난다. 물리망의 IP MTU가 1500이면 원본 Pod IP 패킷은 1450B 이하로 맞춰야 추가 헤더까지 담을 수 있다. 반대로 Pod에서 1500B를 쓰려면 underlay 쪽 MTU를 그만큼 확보해야 한다. (VXLAN 헤더와 MTU)
작은 ping은 되는데 큰 응답이나 파일 전송만 멈춘다면 MTU와 Path MTU Discovery 동작을 확인할 만하다. Pod 인터페이스의 MTU만 보지 말고 노드 NIC, 스위치, 중간 터널 구간까지 같이 봐야 한다.
터널 포트도 구현과 설정을 확인해야 한다. VXLAN의 표준 목적지 포트는 UDP 4789지만, Cilium의 기본 VXLAN 포트는 UDP 8472다. 방화벽이나 packet capture 필터를 잡을 때 이 차이를 놓치기 쉽다. (Cilium 터널 설정)
Pod 경로를 leaf에 BGP로 광고하기
native routing을 쓰면서 Pod 대역을 물리망에서도 접근하게 하려면 그 경로를 알려줘야 한다. 한 가지 방법이 노드와 leaf 사이에 BGP 세션을 맺는 것이다.
이 예시에서는 각 노드가 자신에게 할당된 /24 Pod 대역을 광고한다고 하자. leaf가 두 노드를 직접 연결한 구성이라면 아래처럼 경로를 받을 수 있다.
Node A → leaf: 10.10.10.0/24, next hop = 192.168.1.1
Node B → leaf: 10.10.20.0/24, next hop = 192.168.1.2

leaf의 routing table (예시)
192.168.1.0/24  direct
10.10.10.0/24   via 192.168.1.1
10.10.20.0/24   via 192.168.1.2
앞의 Cilium 그림은 노드의 테이블, 여기 적은 건 광고를 받은 leaf의 테이블이다. leaf는 Pod 하나하나의 MAC을 알 필요 없이 대역과 next hop을 알고, 마지막에 도착한 노드가 자신의 Pod로 전달한다.
Pod가 하나 추가됐다고 항상 BGP 경로도 하나 추가되는 건 아니다. 위처럼 대역 단위로 광고한다면 같은 /24 안에서 Pod가 생성·삭제돼도 leaf의 경로는 유지할 수 있다. 반면 노드가 장애로 사라지거나 할당 대역이 바뀌면 광고한 경로도 그 상태를 반영해야 한다. 실제 광고 단위와 철회 방식은 CNI와 IPAM 구성에 따라 확인해야 한다. (Cilium PodCIDR 광고)
서로 다른 랙으로 넓혀도 원리는 같다. 수신 leaf는 로컬 노드로 가는 Pod 경로를 알고, 다른 leaf는 fabric을 통해 그 대역에 도달할 수 있어야 한다. 다만 노드와 BGP 세션이 올라왔다는 것만으로 fabric 전체에 경로가 전달되는 건 아니므로, 스위치의 광고·수신 정책도 같이 맞춰야 한다.
BGP를 켜는 것과 노드의 전달 설정은 별개다
BGP는 경로 정보를 주고받는 control plane이다. Node A가 보낸 실제 패킷을 Linux routing table이나 eBPF에서 어떻게 처리할지는 별도의 datapath 설정에 달려 있다.
특히 Cilium의 BGP control plane은 연결된 라우터에 경로를 광고하지만, 그 기능 자체가 노드의 datapath를 설정하지는 않는다. native routing과 노드 측 경로가 준비돼 있는지도 확인해야 한다. BGP 세션 established는 Pod 통신 성공을 의미하지 않는다. (Cilium BGP control plane)
Service가 있는데 Pod 경로가 왜 필요한가
애플리케이션에서는 보통 Pod IP를 직접 넣기보다 Service 이름을 쓴다. Pod가 다시 만들어져 IP가 바뀌어도 같은 이름과 ClusterIP로 접근하려는 것이다. 그렇다고 Service가 Pod까지 가는 네트워크를 대신 만드는 건 아니다.
예를 들어 Service의 ClusterIP가 10.96.0.100:80이고, backend로 Pod B의 10.10.20.1:8080이 선택됐다고 하자. kube-proxy의 iptables 모드를 기준으로 단순화하면 아래처럼 된다.
Pod A의 애플리케이션
  → Service 이름을 DNS로 조회
  → 10.96.0.100:80으로 연결
  → Service 규칙에서 backend 선택, 목적지 변환
  → 10.10.20.1:8080으로 전달
  → Node B의 Pod B가 수신
목적지를 backend로 정한 다음에도 그 Pod까지 도달할 경로는 필요하다. 그 구간을 앞에서 본 native routing이나 overlay가 담당한다. Cilium의 eBPF Service 구현처럼 backend를 선택하는 위치와 방식이 달라도, 선택된 backend에 도달할 수 있어야 한다는 점은 같다. (Kubernetes Service proxy 동작)
따라서 “Pod끼리 통신할 수 있어야 한다”와 “물리 스위치에 모든 Pod 경로를 광고해야 한다”는 다른 얘기다. overlay를 사용하면 물리망은 Node IP만 알아도 Service가 선택한 원격 Pod까지 패킷을 보낼 수 있다. Pod 대역을 BGP로 광고하는 것은 물리망에서 그 대역을 직접 라우팅하려는 구성 선택이다.
Pod IP로 직접 접근하는 경우도 있다
모든 통신이 ClusterIP를 거치는 것은 아니다. 예를 들어 selector가 있는 headless Service는 단일 ClusterIP 대신 DNS로 backend Pod의 주소들을 알려준다. 클라이언트는 그중 연결할 대상을 고를 수 있다. (Kubernetes Headless Services)
개별 인스턴스를 구분해야 하는 분산 시스템이나 특정 Pod를 대상으로 하는 모니터링에서도 직접 endpoint를 사용하는 구성이 있다. 이런 경우에도 주소를 어떻게 발견하느냐와 패킷을 어떻게 전달하느냐는 나눠서 보면 된다. Headless Service는 주소를 발견하는 데 쓰고, 실제 전달은 Pod 네트워크가 맡는다.
외부에서 들어오기: MetalLB와 Service VIP
이번엔 클러스터 밖의 client가 서비스를 호출하는 경우다. 앞의 Pod CIDR 광고와 헷갈리지 않도록 주소부터 나눠보자. 아래 Service 주소들은 설명용으로 정한 값이다.
| 주소 | 예시 | 역할 |
|---|---|---|
| Node IP | 192.168.1.1 | 물리망에서 노드에 도달하는 주소 |
| Pod IP | 10.10.20.1 | 실제 backend 프로세스가 있는 Pod 주소 |
| ClusterIP | 10.96.0.100 | 클러스터 내부에서 Service에 접근하는 가상 IP |
| LoadBalancer VIP | 10.100.0.10 | 외부 client에게 노출할 Service 진입점 |
MetalLB를 BGP 모드로 쓰면 Service의 LoadBalancer VIP를 라우터에 광고할 수 있다. 두 노드가 같은 VIP를 광고하고 leaf에 multipath가 설정돼 있으면, leaf는 두 next hop을 사용한다.
leaf의 routing table에 추가되는 경로 (예시)
10.100.0.10/32  via 192.168.1.1, 192.168.1.2  (ECMP)
client가 10.100.0.10:80으로 요청하면 leaf가 먼저 노드를 고른다. 예를 들어 Node A로 보낸 뒤, Node A의 Service 처리에서 Pod B가 backend로 선택될 수 있다. 그 경우 마지막 구간에는 다시 Node A → Node B의 Pod 네트워크가 필요하다. (MetalLB BGP 모드)
Client → LoadBalancer VIP
       → leaf의 ECMP로 Node A 선택
       → Node A의 Service 처리로 Pod B 선택
       → Pod 네트워크를 통해 Node B의 Pod B로 전달
이 흐름은 externalTrafficPolicy: Cluster인 경우의 예다. Local을 사용하면 MetalLB는 로컬 endpoint가 있는 노드에서 해당 Service를 광고하고, 수신 노드도 로컬 endpoint로 전달한다. 불필요한 노드 간 전달을 줄일 수 있지만, 노드마다 Pod 수가 다르면 노드 단위 ECMP가 Pod 단위로도 균등하게 분산되는 건 아니다. (MetalLB traffic policy)
MetalLB가 /32 VIP를 광고했다고 Pod /24 대역도 자동으로 광고되는 건 아니다. 반대로 Pod 대역을 광고했다고 Service VIP까지 외부에서 접근되는 것도 아니다. Pod 대역 광고는 backend로 가는 경로를, VIP 광고는 서비스 진입점으로 가는 경로를 만든다.
이 구분 덕분에 Pod 통신은 VXLAN overlay로 구성하고, 외부 Service VIP만 BGP로 광고하는 조합도 가능하다. BGP를 쓴다는 이유만으로 클러스터 전체가 native routing인 것은 아니다.
실제로 확인할 때는 주소와 경로를 나눠 본다
통신이 안 될 때는 먼저 목적지가 Pod IP인지, ClusterIP인지, LoadBalancer VIP인지 확인한다. 그다음 패킷이 어디까지 도착하는지 보면 조사할 범위를 줄일 수 있다.
아래 명령은 상태를 읽는 용도다. app namespace와 web Service는 예시이므로 실제 대상으로 바꿔서 본다.
# Node IP와 Pod가 배치된 노드 확인
kubectl get nodes -o wide
kubectl get pods -n app -o wide

# Service 주소와 현재 backend 주소 확인
kubectl get svc web -n app -o wide
kubectl get endpointslices -n app -l kubernetes.io/service-name=web -o wide

# 해당 노드의 host network namespace에서 실행
ip route get 10.10.20.1
ip route get 192.168.1.2
ip -d link show
ip route get은 Linux routing table의 판단을 확인하는 명령이다. eBPF가 먼저 패킷을 처리하는 구성에서는 이것만으로 실제 전달 경로를 다 설명할 수 없으므로, CNI의 상태와 관측 도구도 함께 봐야 한다.
| 증상 | 먼저 볼 부분 |
|---|---|
| 같은 노드의 Pod도 통신이 안 됨 | Pod 인터페이스, 로컬 전달 설정, NetworkPolicy, 애플리케이션 listen 주소 |
| 같은 노드는 되는데 다른 노드는 안 됨 | Node 간 연결, 원격 Pod 경로 또는 터널, MTU, 돌아오는 경로 |
| Pod IP로는 되는데 ClusterIP로 안 됨 | Service의 port/targetPort, EndpointSlice와 readiness, Service 처리 규칙 |
| 내부 Service는 되는데 외부 VIP로 안 됨 | VIP 할당·광고, upstream route, traffic policy, 외부 구간 필터 |
여기까지 보면 컨테이너 네트워크도 결국 각 구간의 주소와 next hop을 따라가는 문제로 돌아온다. 다만 노드 안의 Pod 연결, 노드 간 전달, Service의 backend 선택이 겹쳐 있으니 어느 단계에서 막혔는지 구분해서 보는 게 중요하다.
다음 글: L4 — Transport · 이전 글: L3 1편 — 라우팅과 데이터센터 네트워크
그림 출처
Cilium native routing 그림: Authors of Cilium, 공식 문서, 원본 소스. Apache 2.0 라이선스, 이미지 변경 없음.
